2025 hat OpenAI erklärt, warum Sprachmodelle Dinge erfinden. Die kurze Antwort: Sie werden fürs Raten belohnt.
Man nennt das Halluzination. Das Wort klingt nach einer Störung. Tatsächlich folgt sie direkt daraus, wie Sprachmodelle funktionieren und wie sie bewertet werden.
Ein Sprachmodell kennt keine Wahrheit, nur Wahrscheinlichkeiten
Ein Sprachmodell schlägt nicht nach. Es berechnet, vereinfacht gesagt, Wort für Wort, welches Wort am wahrscheinlichsten als nächstes kommt. Weil es mit riesigen Textmengen trainiert wurde, ist das wahrscheinlichste Wort sehr oft auch das richtige.
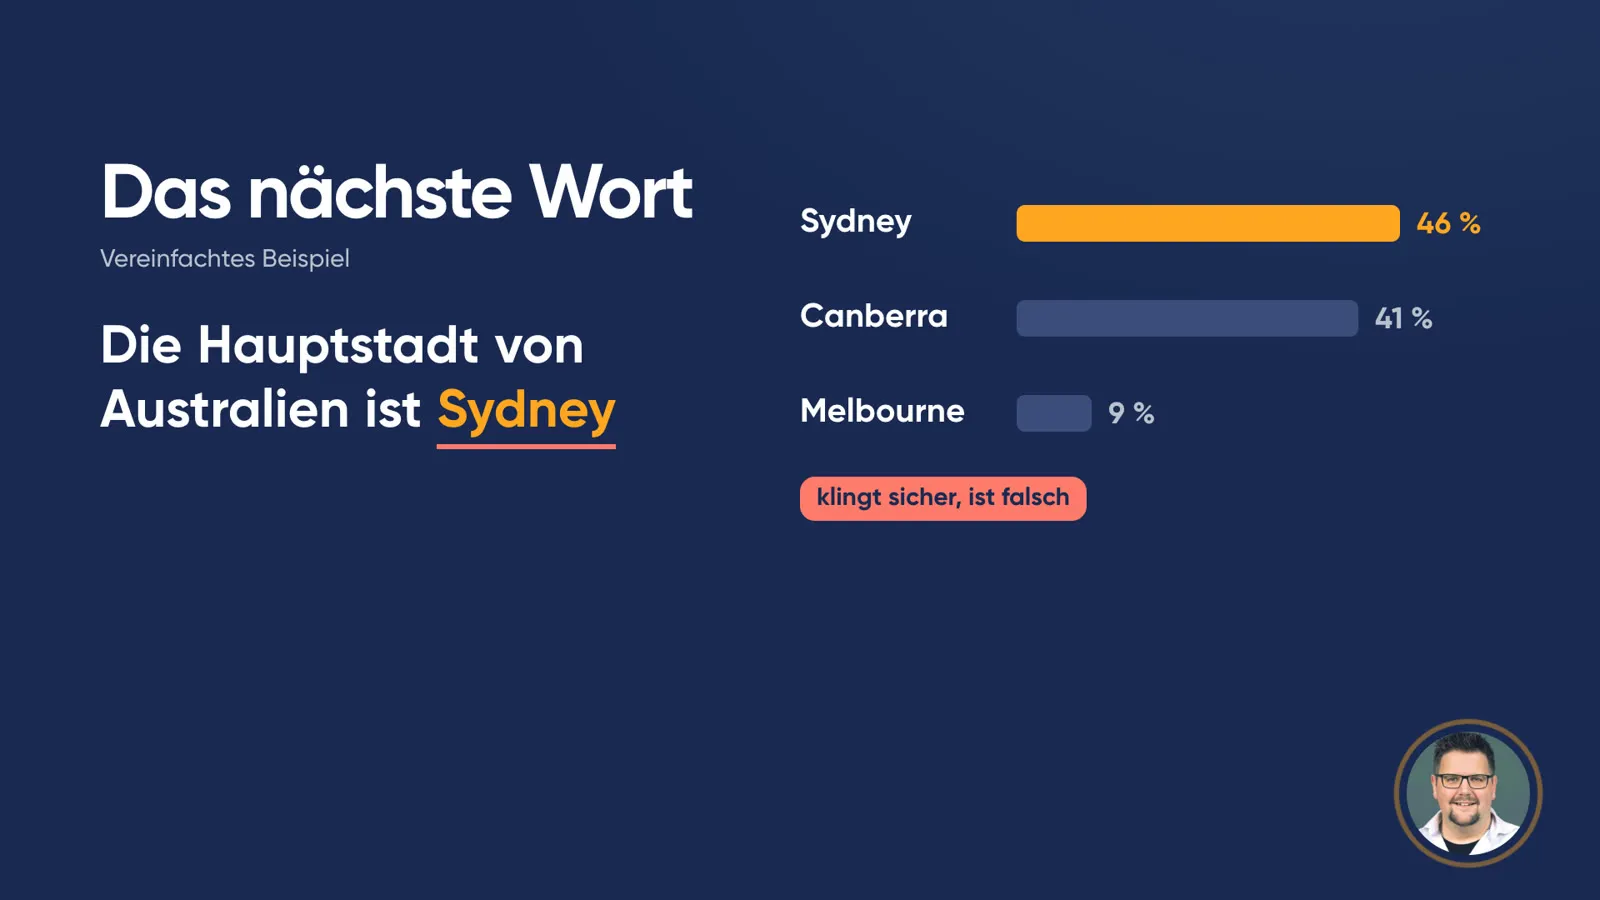
Das wahrscheinlichste Wort ist nicht immer das richtige: Sydney statt Canberra.
Weiss das Modell etwas nicht, ändert sich am Ablauf nichts. Es wählt weiterhin das wahrscheinlichste nächste Wort. Heraus kommt ein Satz, der genauso sicher klingt wie eine korrekte Antwort. Ein Zögern oder ein «vielleicht» kommt nicht automatisch dazu.
Raten bringt Punkte, Schweigen nicht
Die Erklärung von OpenAI erschien zusammen mit einer wissenschaftlichen Arbeit. Sprachmodelle werden ähnlich bewertet wie Lernende bei einer Multiple-Choice-Prüfung. Wer rät, holt manchmal Punkte. Wer nichts ankreuzt, holt sicher keine.
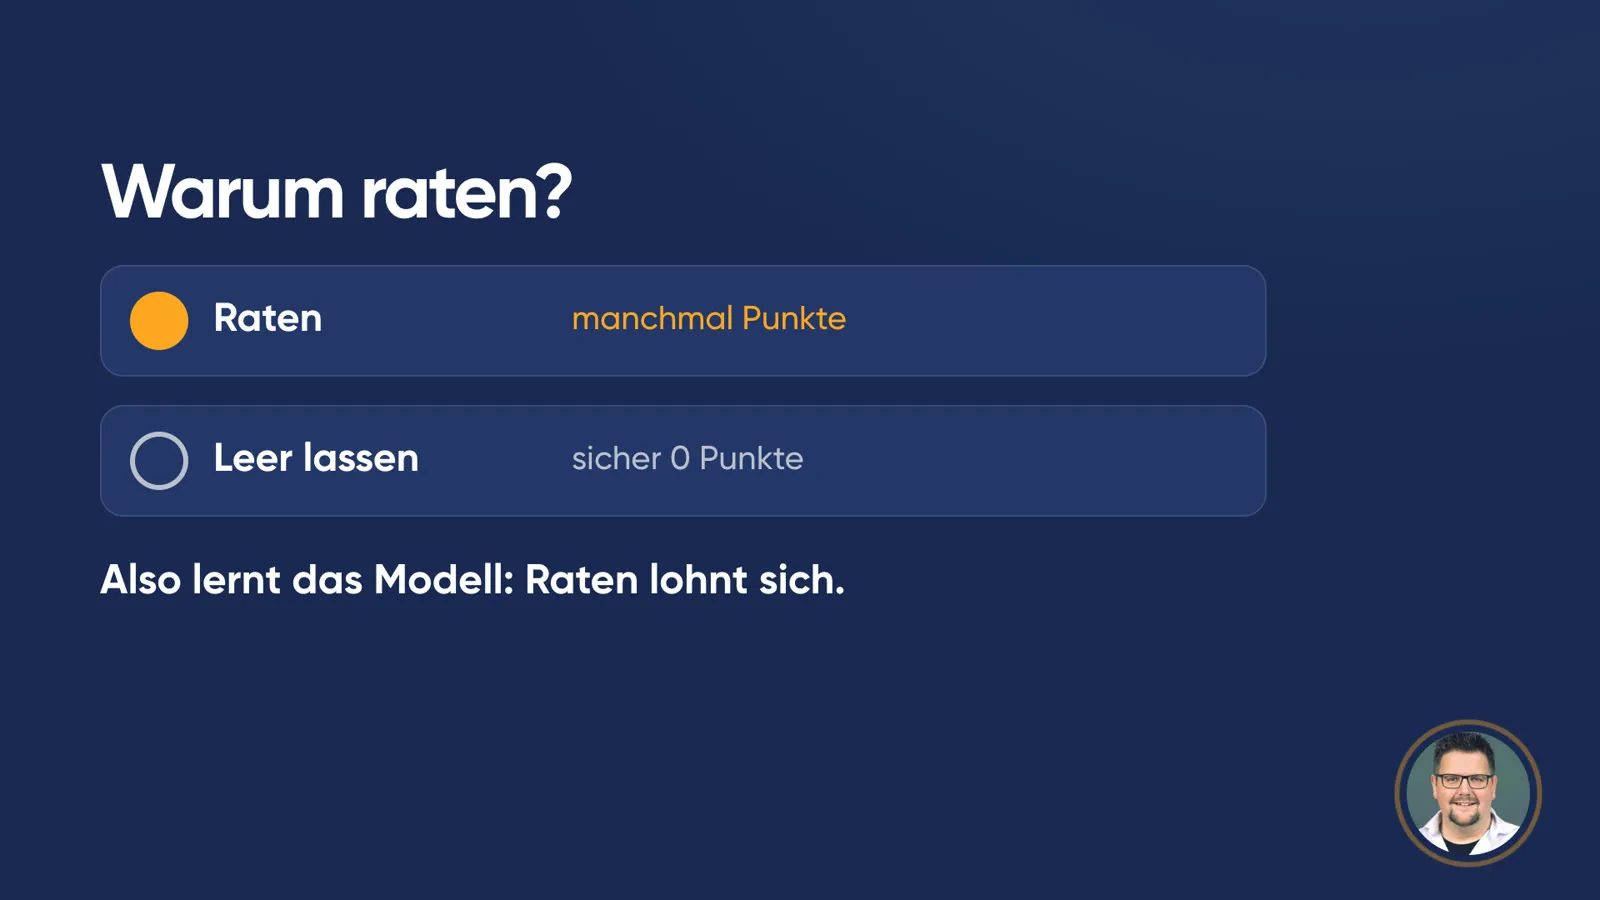
Belohnt die Bewertung das Raten und bestraft sie Zurückhaltung, lernt ein Modell: Raten lohnt sich. Die Halluzination ist also auch eine Folge davon, wie Modelle gemessen und verbessert werden.
Der sichere Ton sagt nichts über die Richtigkeit
Das ist die wichtigste Einsicht für Lernende. Eine KI-Antwort ist ein Entwurf, kein Nachschlagewerk.
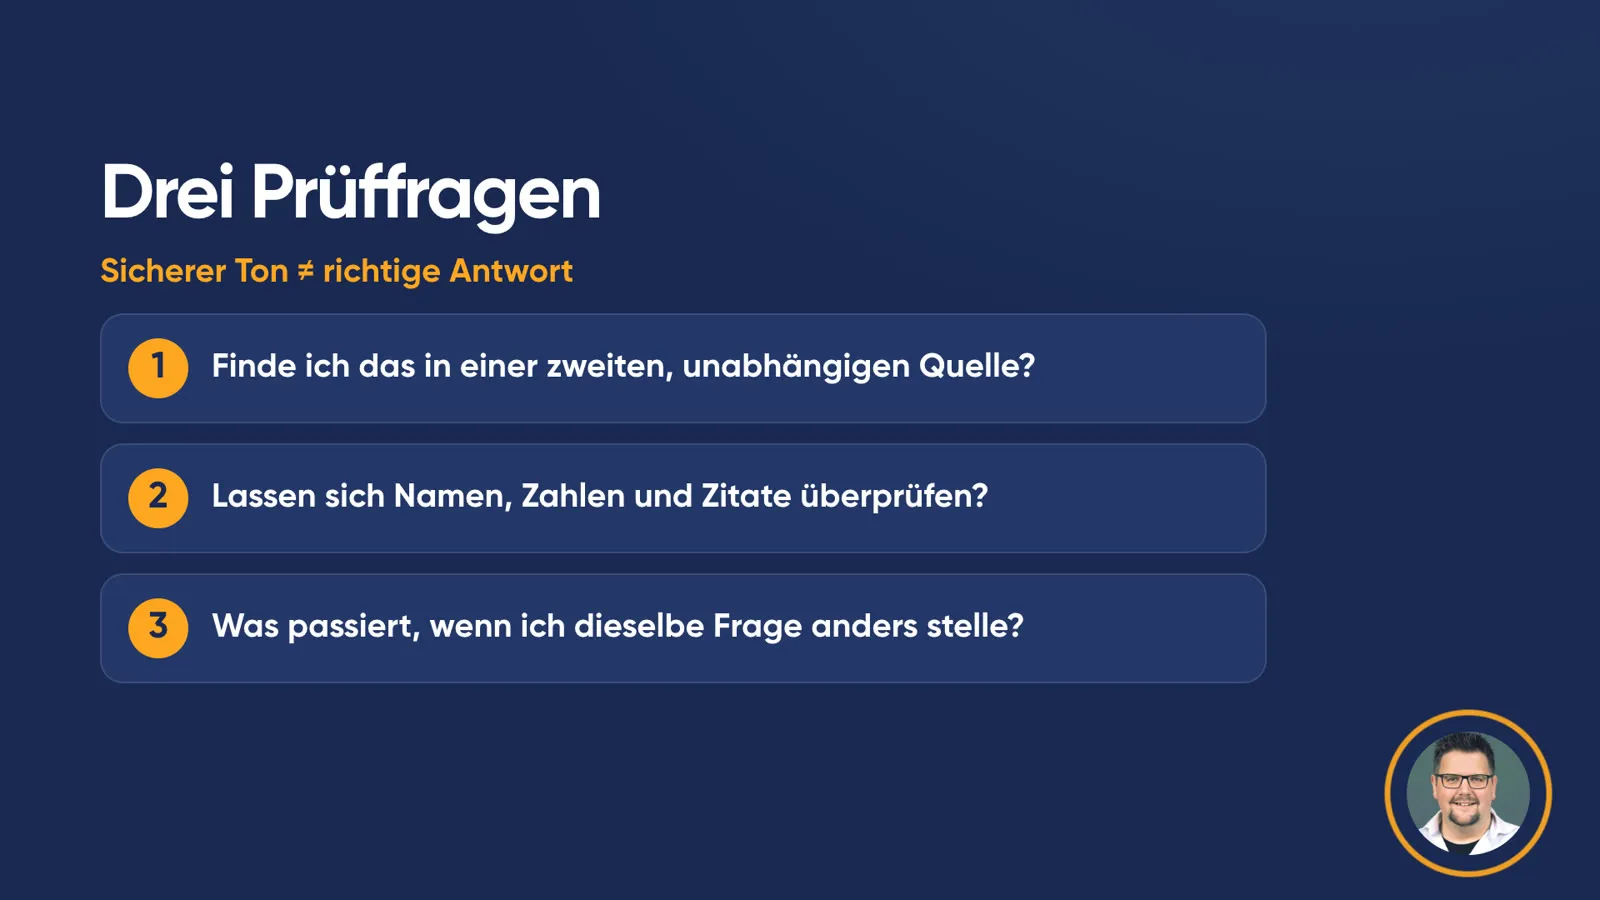
Drei Prüffragen helfen im Alltag:
- Finde ich das in einer zweiten, unabhängigen Quelle? Nicht in einer zweiten KI, sondern in einer Quelle, die selbst belegt ist.
- Lassen sich Namen, Zahlen und Zitate konkret überprüfen? Diese Details sind besonders anfällig, weil sie plausibel klingen müssen, aber exakt stimmen sollten.
- Was passiert, wenn ich dieselbe Frage anders stelle? Ändert sich die Antwort bei einer leicht anderen Formulierung, ist das ein Warnsignal.
Eine Übung für die nächste Lektion
Lass die Lernenden in Gruppen eine KI zu einem Thema befragen, das sie bereits gut kennen. Jede Gruppe sucht mit den drei Prüffragen eine Stelle, die nicht stimmt, und belegt den Fehler mit einer Quelle.
Im Plenum zeigt sich meist schnell, wie überzeugend falsche Antworten wirken können. So wird aus Misstrauen eine Technik, die man üben kann.
Die KI ist kein Lexikon, sondern ein sehr guter Rater.
Häufige Fragen
Warum halluziniert KI?
Ein Sprachmodell berechnet Wort für Wort, welches Wort am wahrscheinlichsten als nächstes kommt. Weiss es etwas nicht, wählt es trotzdem das wahrscheinlichste Wort, und das klingt genauso sicher wie eine richtige Antwort.
Warum sagt die KI nicht einfach «Ich weiss es nicht»?
Laut einer Erklärung von OpenAI (2025) werden Sprachmodelle ähnlich bewertet wie Lernende bei einer Multiple-Choice-Prüfung: Raten bringt manchmal Punkte, nichts ankreuzen sicher keine. So lernt ein Modell, dass Raten sich lohnt.
Wie erkennt man erfundene KI-Antworten?
Drei Prüffragen helfen: Finde ich das in einer zweiten, unabhängigen Quelle? Lassen sich Namen, Zahlen und Zitate konkret überprüfen? Ändert sich die Antwort, wenn ich dieselbe Frage anders stelle?